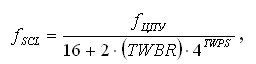Челюскин писал(а):Alkul, Огромное Вам спасибо за помощь, думаю использую Вашу схему. Если будете писать в АВР Студио, я бы попросил исходники (если на асьме будете писать) чтобы самому разобраться во всем!
Да, я пишу на AVR Studio 4.19 на асме. И естественно, я дам Вам все исходники. Не понимаю людей, которые помогают кому-то и жмутся дать исходники.
Но сначала - схемотехника.
В чем Вы рисуете схемы? Если я Вам их в формате P-CAD 2004 дам? Или же удобней в SPlain 6.0 ?
Последний раз редактировалось Alkul Ср май 23, 2012 21:39:11, всего редактировалось 1 раз.
Alkul писал(а):Да, я пишу на AVR Studio 4.19 на асме. И естественно, я дам Вам все исходники. Не понимаю людей, которые помогают кому-то и жмутся дать исходники.
Во-Во!!! не для нарушения авторских прав, а чтобы понять как и чего - мало ли пригодиться в жизни. буду очень ждать
Правильно ли я понимаю, что максимальная скорость модуля TWI, при тактировании контроллера 8мгц, может быть 222,222кгц?
Высчитывал вот по этой формуле. TWPS брал по минимуму = 0. TWBR тоже по минимуму возможного = 10.
Последний раз редактировалось O-LED Чт май 24, 2012 18:44:59, всего редактировалось 1 раз.
Вопросец не из разряда теории, а из разряда личного опыта.. делать ничего не собираюсь, просто интересно
дано :
плис, ацп, срам, и MICROконтроллер с дисплеем
классическая ситуация : плис разруливает чтение\запись во внешнюю статическую память.
теперь сам вопрос. допустим я взял две микросхемы sram. одну под нужды ацп, вторую под задачи контроллера (допустим реализуем фрейм буфер). если обьединить их шины, то получим просто более большое адресное пространство. если не обьединять шины, то можно одновременно, независимо работать с двумя микросхемами, плис разрулит адресацию, но потребуется много ног (почти в двое больше). а если взять и повесить две микросхемы sram на одну адресную шину, а шины данных будут разные (равно как и не обьединем пин(-ы) WE\RE ? получим "память" в которую по одному адресу находятся две ячейки с независимым чтением\записью ?
или такой способ будет крайне неудобным ?
RETI ;рети-рети интеррапт, через шины данных тракт, через память, через порт, возвращайся в главный код
@hobbyelectronics
я как бы понимаю, что бредово уже от того, что обычно во время записи данных с ацп в sram для инкрементирования адреса используется банальный счетчик.. а это жесткая по функциональности штуковина.. максимум что можно - задать начальный, конечный адреса и шаг (ин-/де-)крементирования..
RETI ;рети-рети интеррапт, через шины данных тракт, через память, через порт, возвращайся в главный код
@hobbyelectronics
Кислый писал(а):ли такой способ будет крайне неудобным ?
Можно сделать виртуальное увеличение адреса, лишь бы он не занимал слишком много места.
И в процедуре чтения сделать разделение по адресу:
если в адресном пространстве первой срам, то активируем первую
если в пространстве второй, то ,соответственно вторую.
Насколько могу судить, (некоторые) цифровые осциллографы сделаны с раздельной памятью выборок, которая заполняется с АЦП через ПЛИС, и отдельно есть ОЗУ для МК, куда потом все переписывается и обрабатывается. Может, можно выкинуть какой-то финт, например сформировать в ПЛИСине мультиплексор, который будет наполнять SRAM, а потом подключать ее к МК, давая для МК сигнал готовности. Или, может, в каких-то МК есть режим DMA для ускорения загрузки ОЗУ... но это дилетантские рассуждения, т.к. с ПЛИС не работаю.
SmarTrunk писал(а):......Или, может, в каких-то МК есть режим DMA для ускорения загрузки ОЗУ... но это дилетантские рассуждения, т.к. с ПЛИС не работаю.
Таких МК очень много.
ДМА бывает двух типов: внутрицикловый и с захватом системной шины. Первый подразумевает специальную ОТДЕЛЬНУЮ внутрипроцессорную шину ДМА и двухпортовое ОЗУ. Второй использует общую шину и соответственно теряет время на остановки ядра во время загрузки ОЗУ от периферии.
Внутрицикловый ДМА имеется в PIC24HJ и dsPIC33F. Я использую достаточно недорогой dsPIC33F128MC802(804). Помимо ДМА там имеется 4 УВХ при АЦП, что позволяет СИНХРОННО преобразовывать данные с 4 каналов и упаковывать их в ОЗУ УПОРЯДОЧЕННО...
Правда из 16К ОЗУ только 2К являются двухпортовыми, остальная память ДМА недоступна. Но и этот объем дает широкие возможности.
В МК ATmega8 имеется встроенный 10-битный АЦП. Что значит 10-битный?
Это значит что входное напряжение от GND до Uвх будет линейно разбито на 210 частей.
Минимальный код равен 0, максимальный 2^10 = 1023. Например, у нас максимальное
входное напряжение на входе МК составляет 5В. Значит шаг измерения составляет 5/1024=0.0049,
т.е. 4.9мВ (2,5/1024 = 2.4мВ) Измеренное напряжение преобразуется в 10-битное число и сохраняется в регистрах ADCL и ADCH.
Вот как преобразовать 2,4мВ в 10-битное число пока не знаю!
Это значит что входное напряжение от GND до Uвх будет линейно разбито на 210 частей.
Минимальный код равен 0, максимальный 2^10 = 1023. Например, у нас максимальное
входное напряжение на входе МК составляет 5В. Значит шаг измерения составляет 5/1024=0.0049,
Что это было ???
Напряжение "шага" определяется напряжением Vref, частный случай, когда оно равно напряжению питания...
Это значит что входное напряжение от GND до Uвх будет линейно разбито на 210 частей.
Откуда это число?
Минимальный код равен 0, максимальный 2^10 = 1023.
это правильно.Значение ацп при напряжении 2,5 вольт будет зависеть от источника опорного напряжения.
Таким образом для опорного напряжения +5в шаг будет
5/1024=0.0048828125 соответственно самое большое значение напряжения которое мы сможем отличить
это 5-0.0048875855=4.99511241в
либо 0.0048875855*1023=4.99511241в
все напряжения выше опорного будут показываться как 1023
получается немного неровно,но 2,5в при этом опорном +5в
2,5/0.0048875855=511 или 1FF в шестнадцатеричном коде.
ADCL=0xFF;
ADCH=0x01;
Если же выбрать внутренний источник опорного напряжения 2,56 в,
то шаг 2,56/1024 =0.0025в
максимальное напряжение 2.5575
2,5 при опорном 2,56
2,5/0.0025=1000 или 3E8 в шестнадцатеричном коде.
ADCL=0xE8;
ADCH=0x03;
ILYAUL писал(а):Atmega 128 ,через dragon по ISP отладить можно или нет.
Только через JTAG. Интерфейс ISP не предназначен для отладки. In-System Programming по заглавным буквам. Дракон еще умеет по одному проводу отлаживать - DW (DebugWare Interface), но 128-я мега его не поддерживает, насколько я помню.
ILYAUL писал(а):Atmega 128 ,через dragon по ISP отладить можно или нет. Что-то не врублюсь - debug не запускается . fuse -включён
Во первых непонятно в какой программе вы работаете...
Во вторых если вы не знаете как ставить биты в программе.
советую не пользоваться ничем другим, кроме AVR Studio там единственное где все логично понятно как точно фьюз биты сконфигурировать без заглядывания в ДШ
И вам уже сказали про ISP и дебаг вайр
Здравствуйте. Имеется ПЛИС xilinx Spartan-3e. Необходимо заставить данную плату оцифровывать аудио сигнал и отправлять его на ЦАП в реальном времени (это нужно для дальнейшей обработки сигнала). АЦП и ЦАП на плате имеются, есть готовые реализации, найденные в интернете и написанные лично. Всё упирается в сложность, не могу до конца написать проект. Язык написания VHDL. Если есть люди, которые работали с этой платой или имеют представление как это можно сделать, напишите, пожалуйста. Всю документацию, материалы и наработки могу предоставить. Есть много мелких вопросов, поэтому, наверное, нет смысла их задавать здесь.
Я использовал для управления ацп и цап процессор picoblaze kspcm3. Не могу понять, как подключаются выходные и входные порты процессора к выводам на плате, и не разберусь с кодом на ассемблере для процессора.
Если ошибся темой, направьте в нужное русло.
Откровенно говоря не понимаю зачем там пикоблэйз...
По моему, достаточно было бы сформировать сигналы управления АЦП (один файл), сигналы управления ЦАП (второй файл) и связать эти два "блока" в файле верхнего уровня - ведь никакой обработки в ПЛИС не производите
Загружая на вход компьютера "мусор", на выходе получим "мусор^32".
PS. Не работаю с: Proteus, Multisim, EWB, Micro-Cap... не спрашивайте даже
В дальнейшем предполагаю добавить обработку в ПЛИС, сейчас бы в этом разобраться. Мне показалось решение с процессором намного проще. Так как АЦП, ЦАП, и другие устройства которые можно потом задействовать (кнопки, экран, диоды), подключаются по последовательному SPI интерфейму, и описывать всё это на vhdl крайне долго, по моим прикидкам выйдет намного дольше чем на процессоре, но я новичок, могу ошибаться. К тому же примеры по подключению данных устройств есть на форуме xilinx, и ко всему есть документация, то есть с нуля писать не придётся.
Для описания на VHDL надо думать не программками, а схемами.
Делать сдиговый регистр достаточно просто, например
MOSI<=Sh_rg(7);
Sh_rg(7 downto 1):=Sh_rg(6 downto 0);
Ну нехватает тут еще синхроимпульса - но дело недолгое
Загружая на вход компьютера "мусор", на выходе получим "мусор^32".
PS. Не работаю с: Proteus, Multisim, EWB, Micro-Cap... не спрашивайте даже